OpenAI coloca marca d’água nos textos gerados pelo ChatGPT
textGrain é a marca d'água invisível da OpenAI para texto gerado por IA, anunciada em 5 de outubro de 2026. Ela embute um sinal estatístico nas palavras escolhidas pelo modelo, liga por padrão no ChatGPT e no Codex para usuários da União Europeia e é opcional na API, em resposta ao Artigo 50 do AI Act.
Neste artigo8 seções
O textGrain é a nova marca d'água invisível da OpenAI para texto gerado por IA, anunciada em 5 de outubro de 2026. Nas próximas semanas, o textGrain passa a valer por padrão no ChatGPT e no Codex para quem está na União Europeia, e qualquer cliente da API pode ligá-lo. Se você acompanha IA, entender essa marca d'água ajuda a separar o que ela promete do que ela realmente entrega.
O que é o textGrain, a marca d'água de texto da OpenAI?
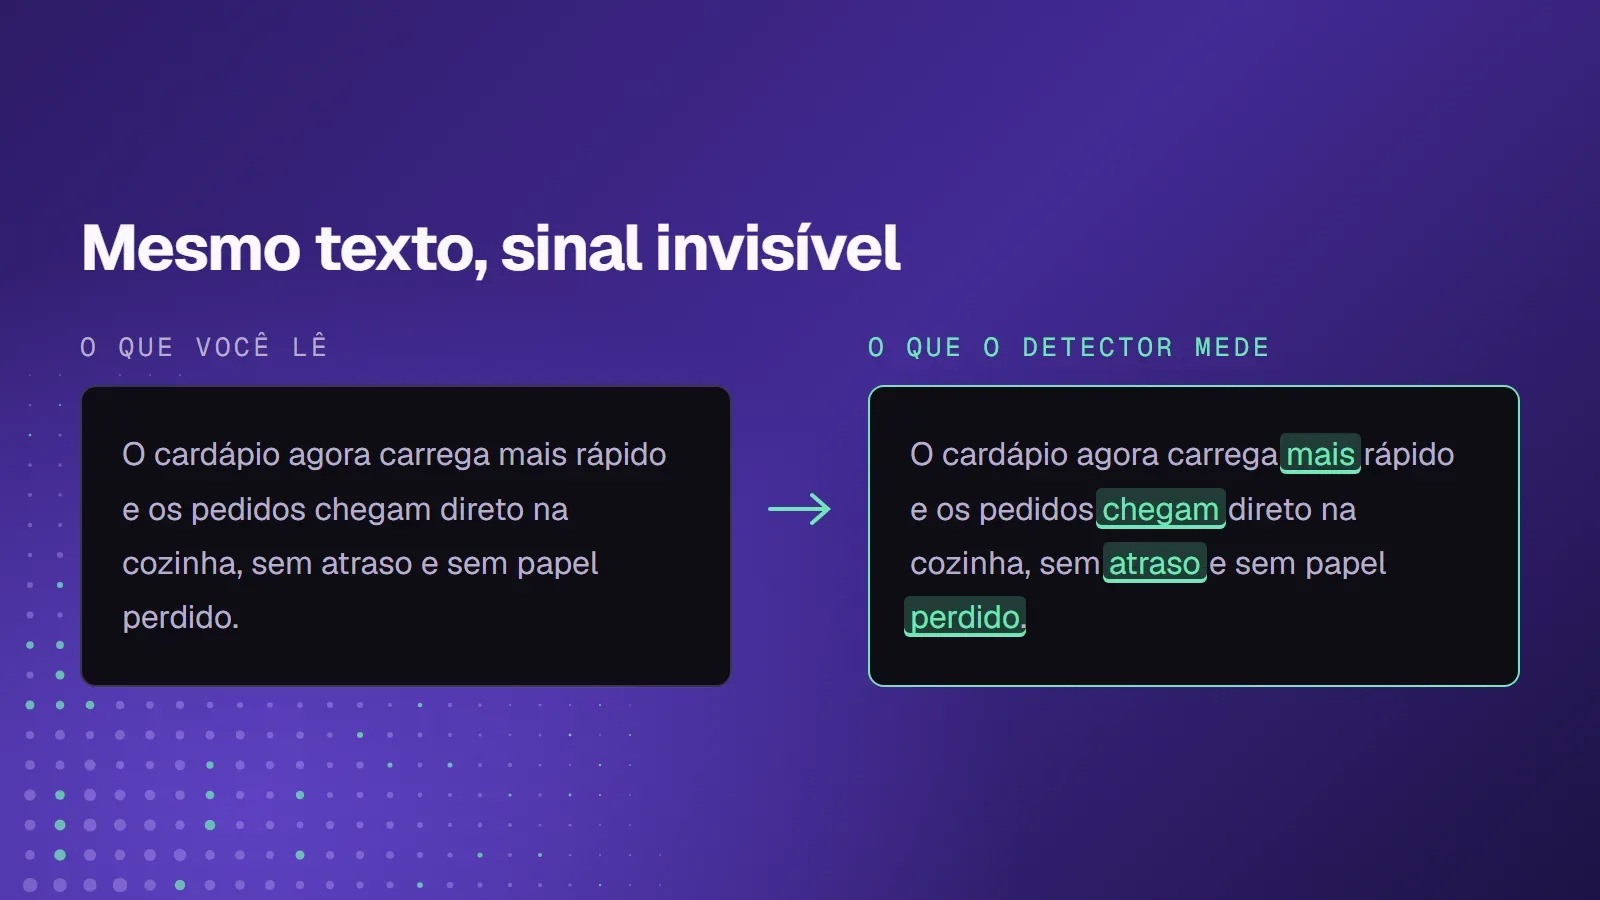
O textGrain é uma marca d'água invisível que a OpenAI aplica ao texto produzido pelos modelos dela, para que esse texto possa ser identificado por máquina como gerado por IA. A marca não aparece para quem lê e, segundo a cobertura do anúncio, não muda o texto de forma perceptível.
Pense em uma nota de dinheiro. Você olha e vê só a cédula, mas um equipamento específico encontra os elementos de segurança escondidos nela. O textGrain segue a mesma ideia: o parágrafo parece normal, mas carrega um padrão que só um detector consegue medir.
A diferença importante é que o textGrain não esconde caracteres especiais no texto. Segundo o The Decoder, a técnica embute um sinal estatístico nas próprias palavras que o modelo escolhe. Copiar e colar o texto não remove a marca, porque não existe nada "a mais" para apagar.
O textGrain é só para texto. Em imagem e áudio, segundo o Trending Topics e o Crypto Briefing, a OpenAI já usa metadados C2PA e a marca d'água SynthID, do Google DeepMind.
Como o textGrain funciona?
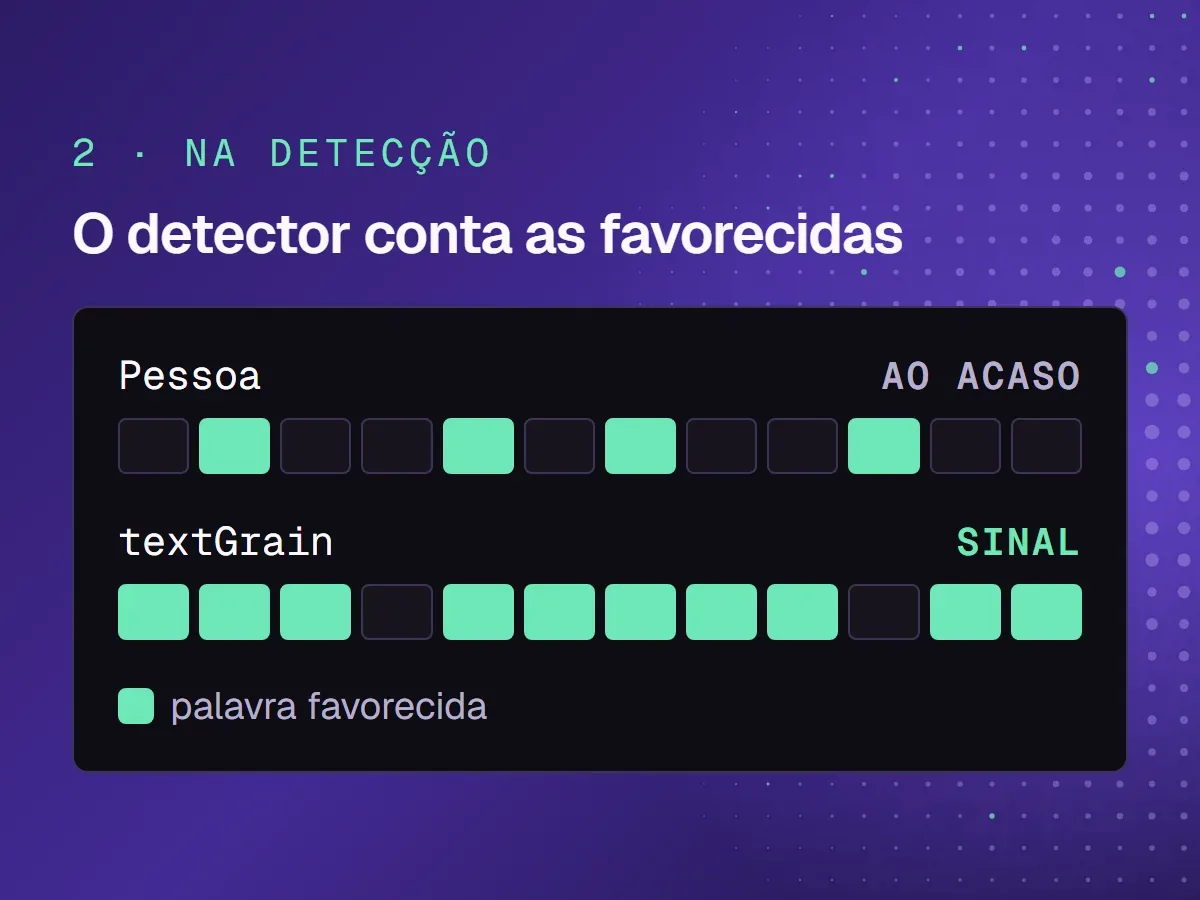
O textGrain funciona influenciando, de forma sutil, quais palavras o modelo escolhe ao gerar um texto, e depois medindo estatisticamente se esse padrão de escolhas aparece. Um texto escrito por uma pessoa não segue o padrão; um texto gerado com a marca segue.
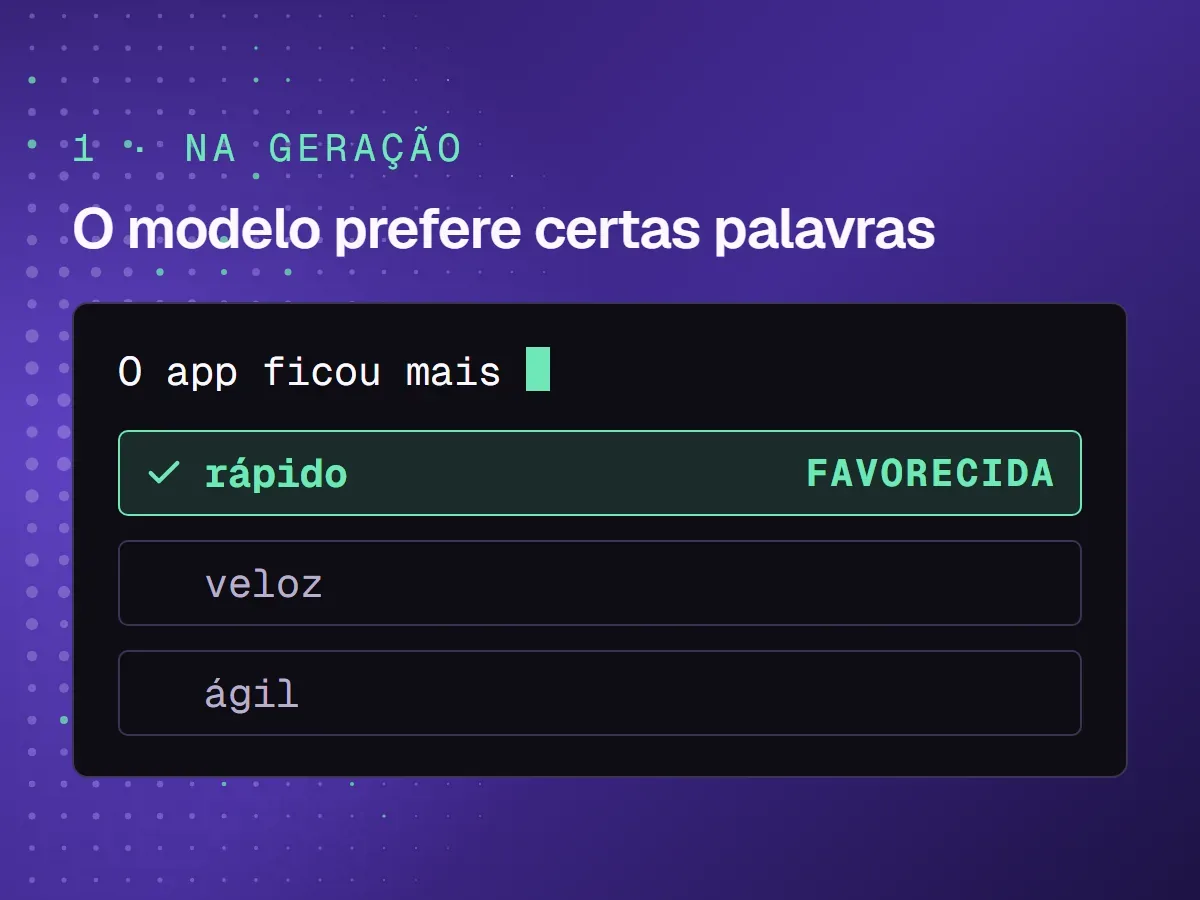
Para entender o mecanismo, lembre que um modelo de linguagem escreve um token por vez (um token é um pedaço de palavra). A cada passo, o modelo tem várias opções plausíveis, como "rápido", "veloz" ou "ágil". Uma marca d'água estatística empurra levemente a escolha para um subconjunto dessas opções, definido por uma regra secreta.
Uma palavra isolada não diz nada. Mas, depois de centenas de tokens, a frequência com que o texto cai no subconjunto "favorecido" fica alta demais para ser coincidência. É isso que o detector mede.
A OpenAI não publicou os detalhes do algoritmo do textGrain. A família de técnicas, porém, é conhecida na pesquisa: o artigo A Watermark for Large Language Models descreve uma marca d'água desse tipo, e a SynthID Text, do Google DeepMind, foi detalhada em um artigo na revista Nature e tem código aberto no GitHub.
Por que o tamanho e o tipo de texto importam?
O textGrain depende de estatística, então precisa de amostra e de liberdade de escolha. Quanto mais longo o texto e quanto mais opções o modelo tem a cada palavra, mais forte fica o sinal.
Isso explica por que, segundo a própria OpenAI, a detecção é melhor em textos sobre psicologia do que em textos de matemática. Em matemática, muitas palavras e símbolos são praticamente obrigatórios, e sobra pouco espaço para o modelo "assinar" as escolhas.
Onde o textGrain fica ligado?
O textGrain liga sozinho só em produtos de consumo da OpenAI na União Europeia; na API, é opcional no mundo todo. A tabela resume o que foi noticiado:
| Produto | Onde vale | Padrão | Observação |
|---|---|---|---|
| ChatGPT | União Europeia, todos os planos | Ligado | Implantação "nas próximas semanas" |
| Codex | União Europeia, todos os planos | Ligado | Inclui código e documentação gerados |
| API da OpenAI | Qualquer país, modelos selecionados | Desligado | Ativação por projeto ou por organização |
| Microsoft Azure | Parceiros de nuvem | Opcional | Só o The Decoder menciona |
Fora da Europa, nada muda no ChatGPT e no Codex por enquanto. O Crypto Briefing cita ainda uma "Content Provenance API" para casos de uso elegíveis, sem mais detalhes confirmados.
Quão confiável é a detecção do textGrain?
A detecção do textGrain é boa em textos longos e intactos, mas cai muito em texto curto, técnico ou editado. Todos os números abaixo são da própria OpenAI, medidos com o detector ajustado para 1% de falso positivo, e não foram verificados de forma independente.
| Cenário testado pela OpenAI | Detecção aproximada | Fonte |
|---|---|---|
| Trechos de 400 tokens sobre psicologia | cerca de 95% | The Decoder; Trending Topics |
| Trechos de cerca de 200 tokens | cerca de 80% | The Decoder; Trending Topics |
| Trechos de 400 tokens sobre matemática | cerca de 60% | The Decoder |
| 10% das palavras trocadas por sinônimos (400 tokens) | de cerca de 92% para 66% | The Decoder |
| 25% das palavras trocadas | abaixo de 20% (The Decoder) ou 17% (Trending Topics) | The Decoder; Trending Topics |
Em outras palavras: trocar uma em cada quatro palavras praticamente apaga a marca. Isso não é um defeito exclusivo do textGrain, e sim um limite conhecido das marcas d'água estatísticas em texto.
O detector também não está aberto ao público. De início, segundo o Trending Topics, só pesquisadores e organizações especializadas selecionados têm acesso, por candidatura analisada caso a caso. O mesmo veículo diz que a OpenAI planeja abrir o código do detector no futuro, mas sem data, e essa informação aparece em uma fonte só.
Vale um contexto histórico. Segundo o Crypto Briefing, a OpenAI teve em 2024 um protótipo interno descrito como "cerca de 99,9% eficaz", que foi engavetado por dúvidas sobre robustez e sobre um possível impacto em quem não tem o inglês como língua nativa.
Por que a OpenAI ligou a marca d'água agora?
A OpenAI ligou o textGrain por causa do Artigo 50 do AI Act da União Europeia, que exige que provedores de IA generativa tornem o conteúdo gerado identificável por máquina. Sem essa marcação, a empresa ficaria exposta a multas no mercado europeu.
Os prazos noticiados são estes:
- 2 de agosto de 2026: o Artigo 50 do AI Act passou a valer.
- 5 de outubro de 2026: a OpenAI anunciou o textGrain.
- 2 de dezembro de 2026: fim do prazo de transição para sistemas que já existiam, segundo o Crypto Briefing.
Segundo o Trending Topics, a multa por descumprimento pode chegar a 15 milhões de euros ou 3% do faturamento global anual. O Crypto Briefing informa ainda que a OpenAI assinou o Código de Práticas da União Europeia em junho de 2026.
Como o textGrain se compara a outras marcas d'água de IA?
O textGrain entra em um mercado que já marca texto: o Google tem a SynthID Text, e a imprensa relata que a Anthropic marca o texto do Claude. O que muda entre as empresas é se a marca é obrigatória ou opcional, e onde ela vale.
| Empresa | Tecnologia | Como aplica | Grau de confirmação |
|---|---|---|---|
| OpenAI | textGrain | Ligado no ChatGPT e no Codex na UE; opcional na API | Confirmado em 2+ fontes |
| Google DeepMind | SynthID Text | Código aberto no GitHub | Repositório oficial |
| Anthropic | Variante da SynthID Text, segundo a imprensa | Global e sem opção de desligar, desde agosto de 2026 | Só relatos da imprensa |
Segundo o The Decoder, a OpenAI diz que o textGrain empatou com outras abordagens ou as superou em testes internos, inclusive a SynthID do Google para texto. É uma comparação feita pela própria OpenAI.
Sobre a Anthropic, o Trending Topics e o Crypto Briefing contam que a empresa adotou em agosto de 2026 uma variante da SynthID Text, aplicada de forma global. Esse dado não foi confirmado em uma fonte da própria Anthropic, então trate como relato da imprensa. Para acompanhar outros assuntos assim, veja os posts sobre Inteligência Artificial.
Quando usar (e quando não usar) a marca d'água na API
Ligue o textGrain na API quando a sua aplicação precisa cumprir uma regra de transparência sobre conteúdo gerado por IA; não conte com ele como prova de autoria. A decisão é por projeto, então você pode ligar só onde faz sentido.
Use quando:
- Você atende usuários ou clientes na União Europeia e gera texto com a API da OpenAI. Esse público provavelmente vai exigir marcação até 2 de dezembro de 2026.
- Seu produto publica texto gerado por IA em escala (descrições, respostas automáticas, resumos) e você quer uma camada técnica de transparência.
- Você quer separar projetos: ligar a marca no projeto europeu e manter desligado em um projeto interno, já que a ativação pode ser por projeto.
Evite contar com o textGrain quando:
- Você quer verificar se um texto de terceiros foi escrito por IA. O detector não é público, então não existe como fazer essa checagem.
- O texto é curto, técnico ou matemático. Segundo os números da OpenAI, a detecção cai para cerca de 60% em matemática e piora ainda mais em trechos curtos.
- O texto passa por revisão humana pesada. Edição e troca de sinônimos derrubam a detecção para abaixo de 20%.
- O conteúdo principal é imagem ou áudio. Nesses formatos, a OpenAI usa C2PA e SynthID, não o textGrain.
Se você usa assistentes de código como o Codex ou o Claude Code no dia a dia, vale lembrar que código e documentação também são texto. Na Formação Claude Code do Zero você aprende a trabalhar com um assistente de código no terminal, do básico ao fluxo completo.
Conclusão
O textGrain é uma marca d'água estatística e invisível que a OpenAI liga por padrão no ChatGPT e no Codex na União Europeia e oferece como opção na API para o mundo todo, por causa do Artigo 50 do AI Act. A detecção funciona bem em textos longos e intactos, mas cai muito em textos curtos, matemáticos ou editados, e o detector não é público. Se você usa a API da OpenAI e tem clientes europeus, o próximo passo é revisar seus projetos e decidir onde ligar a marca antes de 2 de dezembro de 2026; para seguir estudando o assunto, confira os outros posts do blog.
Fontes e referências
As informações sobre o textGrain vêm da cobertura da imprensa publicada em 5 de outubro de 2026, porque a página oficial do anúncio da OpenAI não pôde ser aberta. Os números de detecção são da própria OpenAI.
- OpenAI will watermark ChatGPT text in the EU but makes it optional for API users worldwide (The Decoder)
- ChatGPT text watermark in the EU (Trending Topics)
- OpenAI text watermark for EU ChatGPT and the AI Act (Crypto Briefing)
- Regulamento (UE) 2024/1689, o AI Act (EUR-Lex)
- Scalable watermarking for identifying large language model outputs (Nature)
- SynthID Text, repositório oficial (GitHub, Google DeepMind)
- A Watermark for Large Language Models (arXiv)
- Coalition for Content Provenance and Authenticity (C2PA)
Perguntas frequentes
01A marca d'água do ChatGPT vale no Brasil?
A marca d'água textGrain liga por padrão no ChatGPT e no Codex apenas para usuários da União Europeia, segundo a cobertura do anúncio de 5 de outubro de 2026. Fora da Europa, incluindo o Brasil, nada muda nesses produtos por enquanto. Na API da OpenAI, porém, clientes de qualquer país podem ativar o textGrain manualmente nas configurações do projeto ou da organização.
02Dá para saber se um texto foi escrito pelo ChatGPT com o textGrain?
Na prática, não. O detector do textGrain não é público: de início, a OpenAI libera o acesso só para pesquisadores e organizações especializadas selecionados, caso a caso. Além disso, segundo números da própria OpenAI, a detecção cai bastante em textos curtos, matemáticos ou editados. Por isso o textGrain não serve como ferramenta para professores ou recrutadores checarem se um texto foi gerado por IA.
03Como ativar o textGrain na API da OpenAI?
O textGrain vem desligado na API da OpenAI e pode ser ativado nas configurações de um projeto específico ou da organização inteira, a partir de 5 de outubro de 2026. A opção vale para modelos selecionados, mas a lista exata de modelos compatíveis ainda não ficou clara na cobertura do anúncio. Segundo o The Decoder, a opção também chega por parceiros de nuvem, como o Microsoft Azure.
04Trocar palavras remove a marca d'água do ChatGPT?
Trocar palavras enfraquece muito a marca d'água textGrain. Segundo números da OpenAI citados pelo The Decoder, substituir 10% das palavras por sinônimos derruba a detecção, em trechos de 400 tokens, de cerca de 92% para 66%. Com 25% das palavras trocadas, a detecção fica abaixo de 20% segundo o The Decoder, e em 17% segundo o Trending Topics. Os números não foram medidos de forma independente.
05O textGrain muda o texto gerado pelo ChatGPT?
O textGrain não muda o texto de forma perceptível, segundo a cobertura do anúncio da OpenAI. A marca d'água não insere caracteres escondidos nem símbolos invisíveis: ela embute um sinal estatístico na escolha das palavras feita pelo modelo. Para quem lê, o texto continua com a mesma cara. Só um detector com acesso à chave consegue medir a presença do sinal.
06Qual a multa do AI Act para quem não marcar texto gerado por IA?
Segundo o Trending Topics, a multa do AI Act da União Europeia por descumprir a obrigação de marcar conteúdo gerado por IA pode chegar a 15 milhões de euros ou 3% do faturamento global anual. A obrigação está no Artigo 50 do AI Act, que passou a valer em 2 de agosto de 2026, com prazo de transição até 2 de dezembro de 2026 para sistemas que já existiam.
Leia também
Guia completoInteligência Artificial
REA clona qualquer app? O próprio projeto diz que não
REA (Reverse Engineer Anything) é um CLI, servidor MCP e skill open source que conecta Claude Code, Codex e Cursor a ferramentas de engenharia reversa. Ele explica como um recurso específico funciona, com evidência, mas não recupera o código-fonte original nem clona apps automaticamente, e só deve ser usado em software que você possui ou tem permissão para examinar.
11 min de leitura
NovidadeInteligência Artificial
Claude Haiku fica até 90% mais barato
Claude Haiku 5.5 é o modelo pequeno da Anthropic lançado em 7 de outubro de 2026. Até 100 mil tokens, custa US$ 0,10 por milhão de tokens de entrada e US$ 0,50 de saída, até 90% menos que o Haiku 4.5, e traz controle de esforço e um tokenizador que gera cerca de 30% mais tokens.
6 min de leitura
Guia completoInteligência Artificial
Como criar sistemas completos com Claude Code do zero
Criar sistemas completos com Claude Code é descrever o projeto em português e deixar o agente da Anthropic planejar, programar e testar, com você revisando cada etapa. A Formação Claude Code do Zero, da FullStack Academy, ensina esse método em 14 módulos, do primeiro comando ao deploy de um sistema para restaurantes.
10 min de leitura